Core Insights in the AI Agent Era
Published:
The first thing that AI replaces is AI.
一、从聊天框到 Agent:我亲历的大模型四年
2023 年,我第一次打开大语言模型的网页界面,那时候它还只是一个会聊天的对话框;四年后的 2026 年夏天,ChatGPT 把 Codex 收进同一个桌面端,DeepSeek 把 Harness 开源出来,我开始把任务丢给会读仓库、改文件、跑命令、自己纠错的 Agent。
这四年,变化快到几乎每年都换一次「默认用法」,中间发生的事,不像产品发布会那样一条条蹦出来。中美两家大模型层出不穷,很多也只是昙花一现,渐渐淡出公众视野的不在少数,改名、被拆骨重组的产品,也不比留在聚光灯下的少。
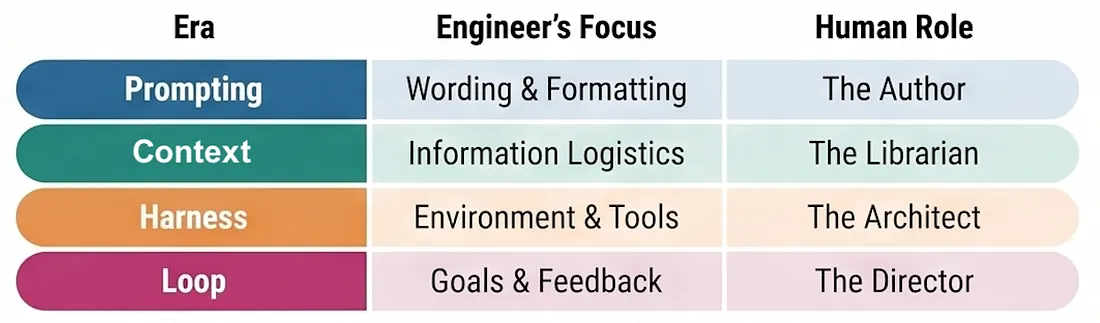
如果只记住大模型发展越来越快,会把四年看错;2026 年春天的那只「小龙虾」,让我认识到AI时代,慢就是快。 旧的没有死,只是不再位于中心:从你打的那句话,到模型看见的全部信息,再到它跑在什么环境里,最后到那个会自己转的循环。真正还在往前走的,是把新能力一层层叠上去的人。
2023:提示词就是全部技能
这一年的关键词就三个:大语言模型(LLM)、提示词(prompt)、幻觉(hallucination)。
那一年 ChatGPT 还是黑盒。中国几乎同步开闸,在上半年挤进公众视野,成了谁都会用的聊天产品;用法也很单纯:打开网页,打字,等回复。很多人第一次觉得「这东西好像真的能干活」:写邮件、改代码、翻译、总结,都能凑合。你要做的就是把角色、步骤、例子、语气塞进同一段话,思维链(Chain-of-Thought, CoT)、少样本提示(few-shot prompt)全是在优化「怎么说」。
这一年的技能是措辞,你需要懂的不多。但再漂亮的提示词,也补不上模型没见过的事实。
在这种模式下,人是循环(Human is the Loop):提问、等待、审阅、再问。那时候「聪明」的标准是:同一道题,换一种问法,答案会不会稳一点。
2024-2025:看见整张桌子
提示词很快不够用。真正决定质量的,变成推理时塞进窗口里的一切:历史、检索、工具返回。提示词变成上下文(context)里的一个子集。
模型又大了一圈,界面上多出来一些开关:「联网搜索」让大模型能查找今天的事、「深度思考」将推理轨迹展开。模型「长出了眼睛和耳朵」,能处理文字、语音、图像,实时语音对话第一次有了产品感。超长上下文被做成卖点,一份长 PDF、一整个代码库开始能塞进去。
概念上,多模态、长上下文、MoE(混合专家)、RAG(检索增强生成) 、工具调用(tool use / function calling)从论文词汇变成产品功能。
文件上传、代码解释器陆续加进来,传文件给大模型,它在后台跑代码,结果从对话框里出来;对话还是对话,但模型已经摸到了工具。真正改变程序员日常的,不是又一个聊天网站,而是 Cursor 这类 AI 原生 IDE;你不用再复制代码去网页,再把答案贴回来。
蒸馏 (distillation)让小模型也能沾得大模型的思考,开源权重不再只是 Llama 的故事,「能自己部署」变成开发者的首选项。
但直到这时,主流用法仍是「人问、模型答」;更聪明,但还不是更自主。聪明和「能替你把一件事做完」,中间还差一层架子。
2026:模型只是灵魂
Harness 就是这层架子——一整套让模型「做完一件事」的环境。
2026 年春天,OpenClaw(在中国被叫成「小龙虾」)给大脑装上手脚:本地跑、接聊天软件、操作浏览器和文件。线下有人排队「养虾」,大约四十天,国家互联网应急中心点名安全风险,舆论翻面,二手平台上的生意从「代装」变成「代卸」。
更巧的是,OpenClaw 的创始人正是后来喊出You shouldn't be prompting coding agents anymore. You should be 「designing loops」 that prompt your agents. (别再给编程 Agent 写提示词了,去设计能提示你的 Agent 的循环。)的 Peter Steinberger——产品比口号更早到达现场。
小龙虾不是假货。方向是对的:Agent 要有身体。它错在被当成可以排队买到的捷径,AutoGPT 是没有身体的脑,小龙虾是还没长好免疫系统的身体。演示超前于可靠性,传播超前于理解,入场费收在高潮,学费付在退潮。 所以「慢就是快」不是劝你躺平,是劝你不要每个四十天重装一次人生。
Anthropic 把 Claude Code 推进终端。表面只是一个命令行,实质是一次用法革命:模型获得了读文件、改文件、执行命令、看报错、再改一版的闭环。你不再把函数贴进对话框,而是让它进你的仓库。 开源世界走出 OpenCode,不绑一家模型,终端里就能换 Claude、GPT、DeepSeek。
模型已经够聪明了,卡住的是它跑在什么里面。OpenAI工程师Ryan Lopopolo用Agents aren't hard; the Harness is hard.概括他带团队用5个月让Codex写出100万行代码的经验。Harness 就是那层「让模型理解环境、调用工具、记住会话、在真实世界里连续工作」的架子:工具、沙箱、权限、记忆、技能、子 Agent、反馈。模型负责聪明,Harness 负责让聪明可依赖。套娃关系从此成立——Harness 装着上下文,上下文装着提示词。Claude Code 负责人 Boris Cherny 那句I don't prompt Claude anymore说的就是这件事:人在设计它干活的环境,不再雕那句完美的话。
用户侧能感觉到的,是入口突然变多。Agent 不仅长在终端里,从 CLI 做到独立桌面应用,再进 VS Code。同一套能力,PowerShell 里是一条命令,VS Code 里是侧边栏,桌面端是一个会自己开 diff 的窗口。于是 2026 年的开发者桌面,通常是叠着用的,而不是选一个信仰:Claude Code 啃硬骨头和长程重构,Codex 走 ChatGPT 账号和云端异步,OpenCode 适合想免费体验的人,VS Code 当公共码头。
MCP(模型上下文协议)、Skills、AGENTS.md 是同一件事的不同层——模型是灵魂,Harness 是身体和手脚。同样一个 Claude 或 DeepSeek,塞进不同的循环里,能干的活完全不一样。API 也在这一年变成基础设施。以前要么直连 OpenAI/Anthropic,要么走中转。2026 年使用者会同时比较:DeepSeek、智谱 GLM、小米 MiMo。API 变成水电煤——谁提供稳定、便宜、长上下文、兼容 OpenAI/Anthropic 协议的 API,谁就能进你的 Agent 里当大脑。
中国没有缺席,只是入口不一样。字节是一条完整链:豆包做 C 端助手,即梦做图像视频,扣子 Coze 搭 Agent,Trae 做 AI IDE,火山引擎 / 方舟聚焦企业数字化服务。字节一度同时铺多个,2026 年夏天开始往回收,整体并入豆包体系,对外要打出「豆包工作」。腾讯把元宝嵌进微信,背后混元也在追推理和 Agent(CodeBuddy 和 WorkBuddy)。DeepSeek 则在 2026 年把故事从「便宜的强模型」升级成「模型 + 运行时」。8 月的 DeepSeek Harness 核心就是 Agent = Model + Harness—— Everything is a plugin(一切皆插件)。
前沿模型榜单每个月都在换,但对使用者来说,差别不再是「会不会聊天」,而是它能不能在一个 Agent 里连续工作几小时把事做完。Harness 可以理解为一套完整的执行环境或运行时的框架,它位于大语言模型与外部世界之间,负责组织模型完成任务所需要的各种资源和流程。
Harness 让 Agent 能干活,Loop 决定它能不能连续干、干到什么时候停——自动化触发、worktree 隔离、skills、连接器、子 Agent、外部状态。现在你设计「做 → 检查 → 记住 → 再做」,直到测试通过、步数用尽、或没有进展了再把你叫回来(Human in the Loop)。瓶颈从模型换成了验证器:测试、编译、类型检查,这些不会撒谎的信号;没有硬校验的地方,循环就会空转。
到这里,2023 年那个只会说话的黑盒,变成了 2026 年会自己改仓库、自己跑测试、自己停下来等你验收的东西。我用 DeepSeek 推导数学公式,用文心和豆包润色,用千问点过外卖打过车,现在把仓库交给 Claude Code、Codex、OpenCode 这类入口。界面上那个「关闭联网、只读文件」的谨慎没有过时,它变成了 Harness 里的权限和上下文策略。
快的那一层,已经不在模型参数上了。模型战争还在打,战场已经换到「循环跑在谁的环境里」。四年其实只做了一件事:把人从循环里拿出来。提示词还在,上下文还在,环境还在,只是现在转起来的是 Loop。还没变的是:模型仍会幻觉,你必须会拍板;Agent 仍会把仓库搞乱,你必须会审。变了的是分工:以前你是作者,模型是建议者;现在模型是执行者,你是编辑和负责人。下一阶段是更可靠的手脚,以及你愿不愿意把钥匙交给它。
二、AI Agent时代的核心洞察与判断
熟练使用AI的人会取代不会使用AI的人
AI不能取代的是那些需要被追责的岗位
AI时代最重要的是判断力/逻辑性/批判性
Agent能做模型推导和数据处理,那么经济研究更重要的方法
Agent能做出来就一定能做好,但需要规范的Workflow和Hook
未来发展是让Agent真正长出手脚,让机器人不只是人形机器
不会用 AI 的人  ──被取代──►  会用 AI 的人(命题1)
                                      │
                                      ▼
                       执行交给 agent,人留下判断(命题3)
                                      │
                    ┌─────────────────┼─────────────────┐
                    ▼                 ▼                 ▼
                方法/识别          追责/签字       workflow/hook
                (命题4)          (命题2)         (命题5)
                    │                 │                 │
                    └─────────────────┬─────────────────┘
                                      ▼
                     agent 长出手脚,进入物理世界(命题6)
                          形态不限于人形,服从任务
1. 熟练使用 AI 的人会取代不会使用 AI 的人
经济学里一对”完全替代“和”完全互补“的概念,被取代的不只是职业,而是同一职业里不会把 AI 当杠杆的人。竞争发生在岗位内部,不是岗位之间。
劳动生产率差距一旦拉开,组织会用更少的人完成相同的产出。当会用 AI 的人产出是原先的 2–5 倍时,不会用的人不是慢一点,而是单位劳动力成本已经没有了竞争力。真正的分界不是“会不会打开 ChatGPT”,而是会不会拆任务、给约束、验结果、把一次性对话沉淀成可复用的工作流。
2. AI 不能取代的是那些需要被追责的岗位
AI 可以替代任务,但不能替代法律人格。社会要的不是“谁算得快和对”,而是“出事了找谁”。
现代组织把工作拆成两截:
- 产出(报告、诊断、代码):机器可以做,而且越来越好。
- 归责(保险、签字、宣誓):必须落在有财产、有执照、可被起诉、可被吊销资格的主体上。
AI 没有营业许可、伦理义务、职业声誉,所以在医疗、航空、法律、审计、金融监管、公共决策里,人不是因为更聪明才留下,而是因为制度需要一个可惩罚的节点。这不是技术限制,技术再强,只要事故、误诊、冤假错案还存在,责任节点就不能落空。
追责岗位内部仍会被劈开:
- 可自动化的:检索、起草、初筛、合规核对
- 不可自动化的:最终判断、告知同意、出庭、签字
AI 取代的是追责岗位里的执行部分,放大的是追责本身的稀缺性。 一个能担责的人,会指挥一群 Agent,覆盖过去十几个人的工作量。
3. AI 时代最重要的是判断力 / 逻辑性 / 批判性
这三者其实指向的是同一方面:对模型输出保持不信任,直到证据闭合。
AI 把三件事变便宜了:写作、计算、检索。于是人类的旧优势(记忆、文笔、套公式)开始贬值。新优势是:在多个看似合理的答案里选择一个最优的;检查推理链是否闭合,有没有偷换概念、因果倒置;主动找反例、找识别假设、找数据生成过程的污染。更危险的是反向螺旋:越把思考外包给 AI,批判主体越萎缩,而独立、清醒地思考恰恰是 AI 时代人类最珍贵的技能。现如今 AI 视频、AI 广告泛滥、以假乱真,更需要“先怀疑、后核实”,通过多个渠道交叉验证,切勿轻信和仅凭单一信源下结论。
4. Agent 能做模型推导和数据处理,经济研究更重要的是方法
或许是源于我对理论计量经济学的热爱,Agent 可以接手推导和清洗工作之后,新方法(识别策略)仍然是被当成工具而不是由 Agent 创造。近年来“双重机器学习”、“大模型数据标注”的研究如火如荼,在中文顶刊上也是如日中天:大模型标注把数据做出来,双重机器学习让高维数据能识别因果。
| 可被 Agent 加速 | 仍主要靠人 |
|---|---|
| 文献综述、数据清洗、回归、图表 | 提出可识别的问题和新的方法 |
| 公式推导、代码实现、复现已有研究 | 选择识别策略(IV、DID、RDD、结构模型) |
| 预测、分类、非线性拟合 | 基于制度与历史等经验知识判断 |
机器学习回答的是预测,政策与机制回答的是因果。Agent 越强,不会计量经济学理论和方法的人会越快暴露,他们会得到漂亮的系数和完全错误的故事。会方法的人则把 Agent 当成超级 RA:一夜就能学完过去一学期的稳健性知识和完成对应操作。
5. Agent 能做出来就一定能做好,但需要规范
我在今年暑假用 Agent 完成了一篇实证论文,算是打通了 AI 辅助科研的全流程。对此我的态度非常乐观:能做出来,就具备了做好的前提;要稳定做好,必须靠 workflow 和 hook,而不是靠下一次运气。Your AI isn’t failing you. Your workflow is.
能力(capability)和可靠性(reliability)是两回事。LLM 是概率系统:同一任务,有时 90 分,有时 40 分。提示词管不住长尾,要把它变成生产系统,必须在概率外面加确定性约束:
- Workflow:把任务拆分成不同的阶段(计划 → 执行 → 验证 → 修复),禁止 Agent 一口气做完,防止模型越跑越偏。
- Hook:在关键节点强制插入确定性动作。针对整个会话生命周期,从开始时加载环境变量,结束时归档记录 ;编辑修改文件后、Shell 命令执行前需要获取权限审批 ,拦截危险命令、验证输出格式……
6. 未来发展是让 Agent 真正长出手脚
2026 年春晚被宇树机器人刷屏,8月19日宇树科技上市,四天跌了2000亿。但我的判断仍然是下一跳不是更像人的机器人,而是 Agent 获得作用于真实世界的效应器。人形只是一种形态,手脚的本质是「感知—决策—执行」闭环。
“长出手脚”有两层:
- 数字手脚:浏览器、终端、机械臂驱动、车载控制,这些已经开始。
- 物理手脚:传感器 + 执行器 + 实时反馈与控制,才是具身智能(embodied / physical AI)。
形态服从任务,不服从科幻。“脑”已经很强,用“脑”操控“手脚”才是瓶颈,也才是下一轮产业主战场。我可以大胆作出推断:技术进步一定是快于人口规模结构调整的,创新活动会达到一个稳态;科技发展越来越快,但没有技术上限或“技术封锁”;当具身智能真正落地时,短期内低廉的劳动力(只是事实判断而非价值判断)不会被高昂成本的机器人所取代,但我依然期待和憧憬着那一天的到来!
综上,Agent 时代的分工是:机器负责能做,流程负责做好,人负责该不该做和出了事谁来扛;下一步是给这套分工装上真实世界的手和脚。