Afterword of Linear Algebra (2)
Published:
It’s 2026, why do I learn Linear Algebra again?
2026年了,我为什么要重学线性代数?要回答这个问题,需要从三方面讨论。
一、为什么是2026年?
这个问题的等价问题是“大模型为什么是今天才出现,而不是更早?”
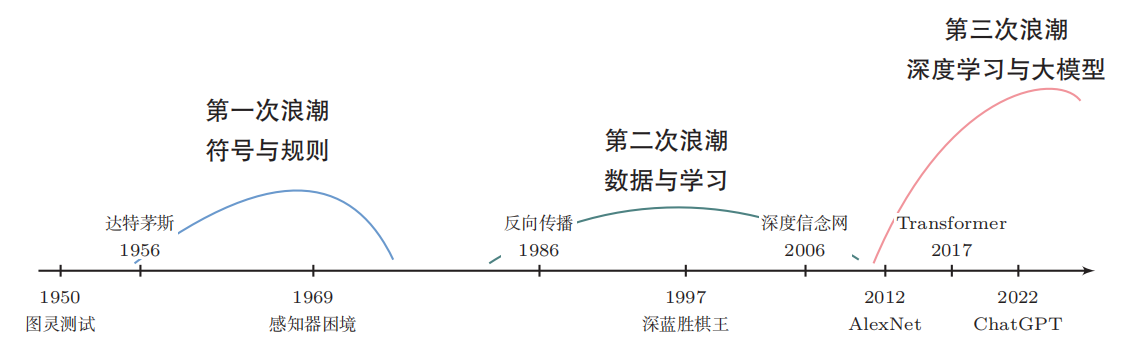
复旦大学邱锡鹏老师给出了解答:
数据:互联网让海量标注数据第一次成为可能。
算力:GPU原本是给游戏做图形渲染的,但它天然适合神经网络那种大规模并行计算。
软件:开源深度学习框架让搭建复杂网络从一件专家活变成任何研究生都能做的事。
得益于人工智能的发展,我在学习线性代数时有了前几年没有的外部条件:
- AI翻译、AI配音、AI画质修复降低了学习门槛。以往只能啃英文原版高糊视频,如今B站上新了中配版(有人可能会批驳应该沉浸式体验原汁原味的英文环境,但我们是为了学习线性代数而不是通过学习线代学英语),在接收母语信息时所需要的理解时间是更短的,表达等量信息在中文语境下所需时间也更少(中文能承载更高密度的信息量);另外一些专业词汇以及GS有很多口癖对初学者不太友好。
- DeepSeek有了强推理逻辑和长上下文。本系列笔记由DeepSeek撰写初稿,极大减少了码字、查资料的时间,电子笔记因其易储存、可分发的特点使得无纸化笔记逐渐占据主流,在DeepSeek撰写初稿后我们只需要稍做修改与排版,人的角色变成了“判断者”与“核查者”而非“创造者”,我们用DeepSeek辅助科研与学习,且随着模型的发展、迭代与增强,AI幻觉正在逐步减轻。
除了外部环境的变化,我自身的内部条件也有了改变,有了高级计量、高级宏观、社会网路、空间计量、机器学习等专业知识的积累,能从跨学科和更高维度重新考察线性代数,从而达到运用的目的。
二、为什么要学习线性代数?
正如上一部分提到的,线性代数在计量经济学、机器学习中有广泛应用。
我校计量经济学入门教材选择的是伍德里奇《计量经济学导论》,这本书没有采用矩阵表述,真正使用矩阵表述还要到中高级计量;但在此之前使用的是张晓峒老师的《计量经济学基础》,智慧树/知到上有配套视频,有网友认为没必要用线性代数知识,在这样的初级课程中,不必要地增加了难度。可能老师比较方便讲,没有考虑学生的接受情况。现实情况是因为nk学计量之前已经学完线代了,不用白不用。
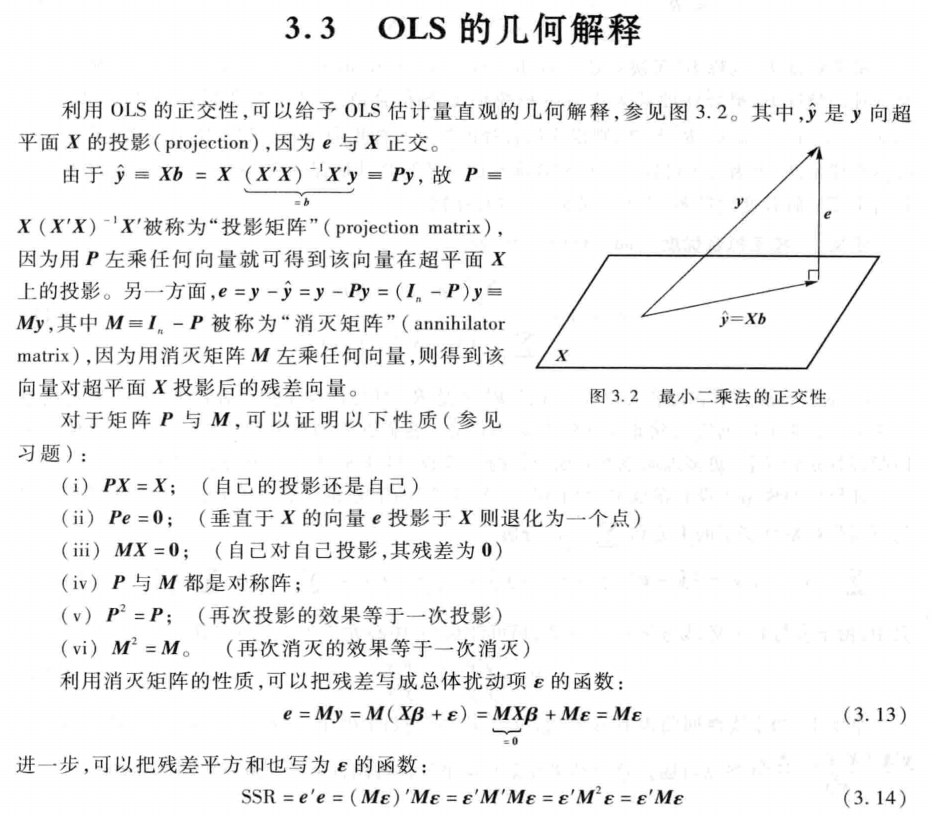
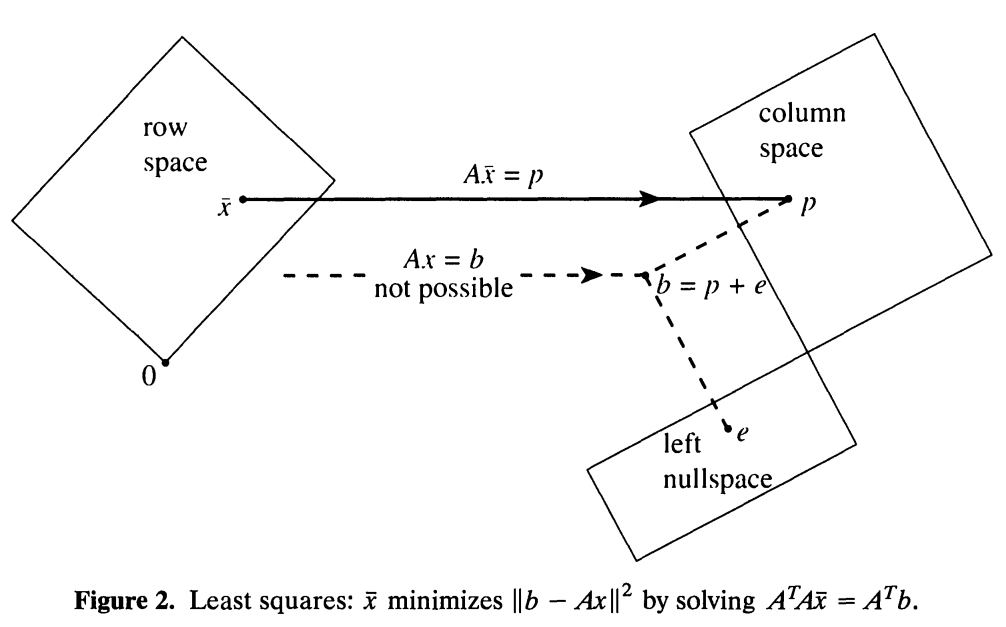
线性代数简化了计量的表达方式,核心参数估计量依赖于矩阵转置、乘法以及逆矩阵求解;若解释变量矩阵X不满秩(即存在完全的多重共线性),则逆矩阵不存在,模型无法估计;课程中有专门讲投影矩阵和最小二乘法的一讲,但由于我对这部分太熟悉了,就没有拓展延申,直接放一张图:
线性代数在数据科学与机器学习中应用更甚,看GS另一本《线性代数与数据学习》的目录:
1. 线性代数的重点
2. 大规模矩阵的计算
3. 低秩与压缩传感
4. 特殊矩阵
5. 概率与统计
6. 最优化
7. 数据学习
	7.1 深度神经网络的构建
	7.2 卷积神经网络
	7.3 反向传播与链式法则
	7.4 超参数:至关重要的决定
	7.5 机器学习的世界
线性代数是机器学习的核心数学基石,机器学习中的样本、特征、模型参数都以向量、矩阵的形式存储和运算,线性代数是描述这类高维数据的标准语言;从线性回归、主成分分析(PCA)到深度神经网络的反向传播,核心逻辑都依赖矩阵运算、线性变换等线性代数知识实现;利用正交变换、卷积运算完成图像特征提取、降噪等操作,是计算机视觉任务的基础。
三、线性代数学什么?
传统线性代数教材和课堂从行列式开始,但GS的课程给我们打开了一扇新世界的大门,而他最知名和最引以为傲的便是四个基本子空间的图象。
我们不妨通过GS《The Fundamental Theorem of Linear Algebra》这篇文章来总结线性代数基本定理,对整个课程核心做一个梳理。
线性代数的学习存在一个关键的“认知跃升”。初学时,我们只把Ax看作是一堆数字的乘加运算;但真正理解线性代数,必须将Ax视为矩阵列的线性组合。
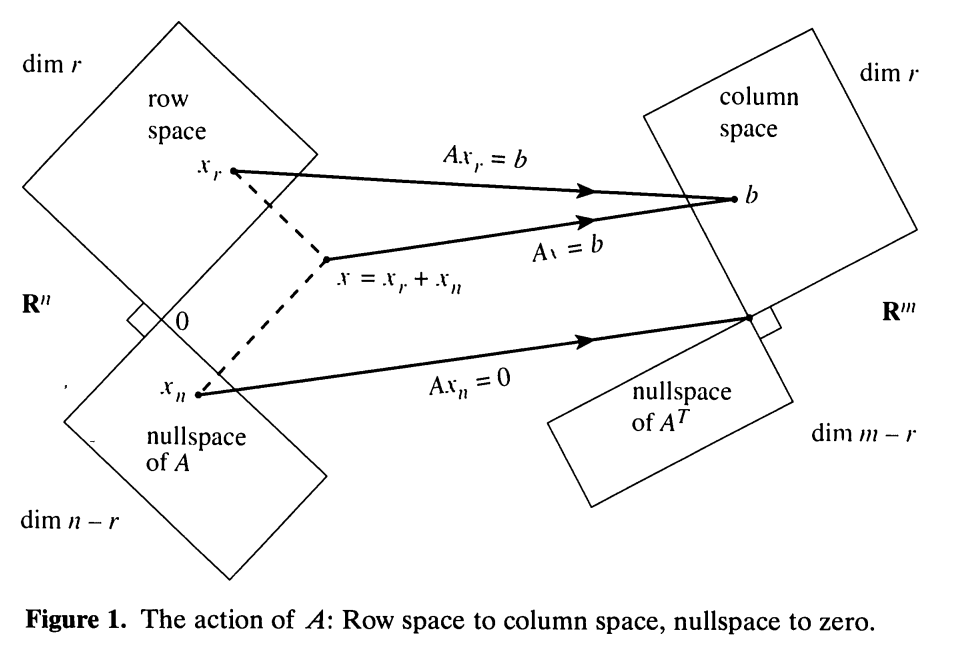
线性代数基本定理第一部分:维数关系(Dimension)
四个子空间的“大小”规律,是理解方程组结构的基础。
- 矩阵的行空间和列空间拥有完全相同的维度,将这个共同的数字称为矩阵的秩r。
- 行空间的维度r加上零空间的维度n-r,等于矩阵的列数n。
- 列空间的维度r加上左零空间的维度m-r,等于矩阵的行数m。
- 将矩阵化为行阶梯形后有主元列和自由列,主元列的个数就是秩,它们撑起了列空间;而自由列的个数(即列数减去秩)则对应着可以自由取值的变量,这些自由变量撑起了零空间。因此,未知数的总数被分成了两部分:一部分映射到列空间(受约束),另一部分归入零空间(可自由波动)。
线性代数基本定理第二部分:正交性(Orthogonality)
子空间之间的“几何垂直关系”,构成了两套正交分解。
- 零空间与行空间互相垂直:所有满足Ax=0的x,它们与矩阵的每一行做内积(对应分量相乘后相加)的结果都为零。既然它与每一行都垂直,那么它必定与这些行的所有线性组合(即整个行空间)也垂直。
- 转置带来的对称结论:列空间与左零空间也是互相垂直的。其中,左零空间是满足A’y=0的y,它们站在矩阵的左侧消去了所有行组合。
现实中Ax=b往往无解,因为方程个数往往远多于未知数(例如用直线或抛物线拟合现实数据)。
- 既然无法让误差为零,我们退而求其次,寻找一个“最佳”输入向量,使得矩阵乘以它得到的结果与真实的已知向量之间的误差最小。
- 要让误差长度(距离)最短,矩阵乘以最佳输入向量所得到的点,必须是已知向量在列空间上的垂直投影,此时误差向量与列空间垂直。
- 误差向量垂直于列空间,那么它必然属于左零空间。将误差的表达式代入,便可得到正规方程组。
线性代数基本定理第三部分:标准正交基
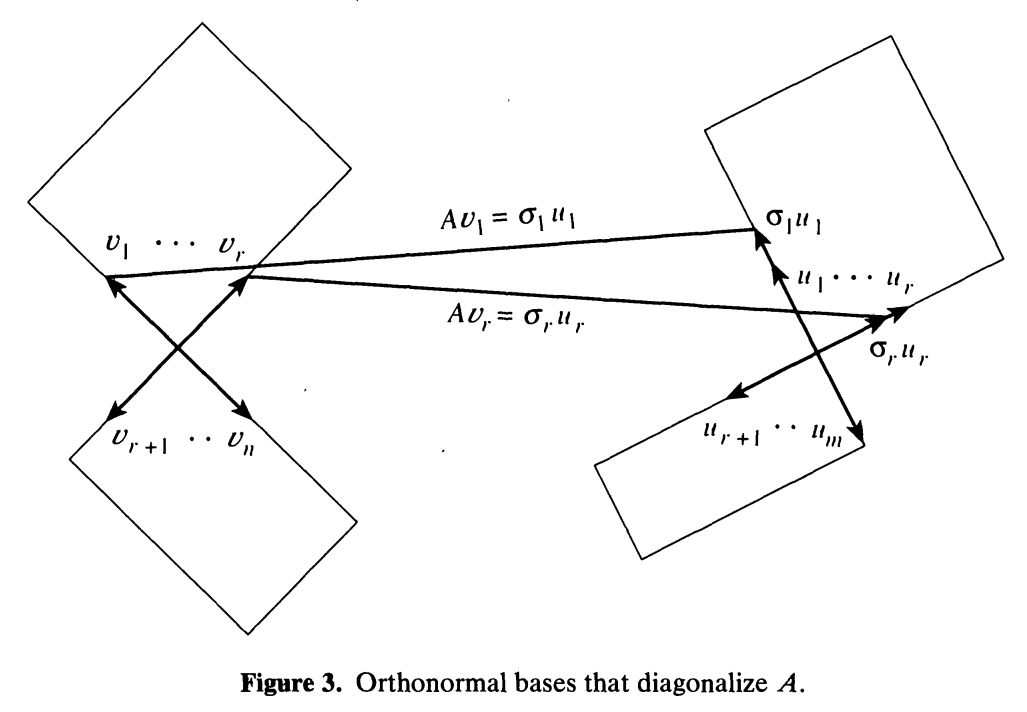
消元法(LU分解)或格拉姆-施密特正交化(QR分解)都能给出基,但它们不够完美。要求:
- 四个子空间的基向量必须全部是标准正交的(即每个向量长度为1,且两两互相垂直);
- 矩阵在这两组基底下的作用必须是对角化的(即每个输入基向量只映射到对应的一个输出基向量上)。
线性代数基本定理第四部分:奇异值分解(SVD)
- 对于输入空间,选取一组标准正交基,其中前几个张成行空间,剩下的张成零空间。
- 对于输出空间,也选取一组标准正交基,其中前几个张成列空间,剩下的张成左零空间。
- 要求矩阵在这两组基下对角化。这意味着:当矩阵作用于行空间的第i个基向量时,结果恰好等于某个正数(称为奇异值)乘以列空间的第i个基向量。
- 怎么找到这些基和奇异值呢?可以先构造A’A这个对称方阵,它的特征向量就构成了输入空间的标准正交基,它的特征值开根号后就是那些奇异值。接着,矩阵乘以这些输入基向量,再进行归一化,就自然得到了输出空间的标准正交基。
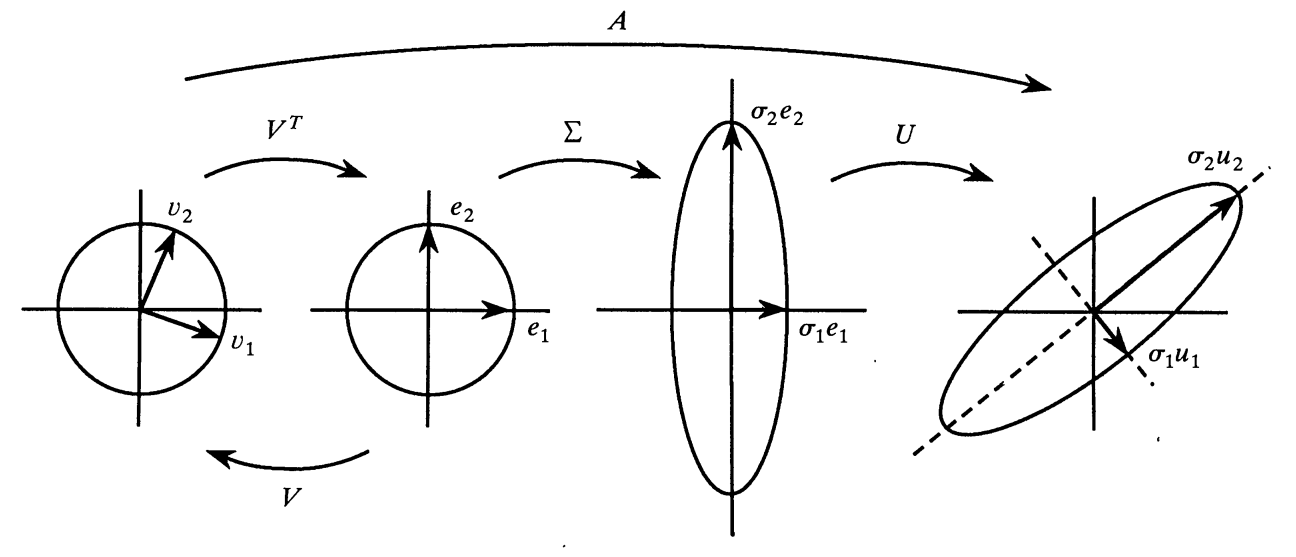
任意一个矩阵,无论形状是方的还是长的、宽的,也无论其元素是否对称,都可以分解为三个矩阵的乘积:最左边的U是一个列向量标准正交的矩阵,最右边的V‘是一个行向量标准正交的矩阵的转置,夹在中间的是一个对角矩阵,其对角线上的正数就是奇异值。
伪逆(广义逆矩阵)
当矩阵不可逆,甚至不是方阵时,我们仍然需要一个“尽可能地像逆”的替代品,这就是伪逆。
伪逆是一个线性变换,它在列空间上执行矩阵的逆操作——把列空间的第j个基向量,映射回行空间的第j个基向量并除以对应的奇异值;而它在左零空间上则什么也不做,直接输出零。
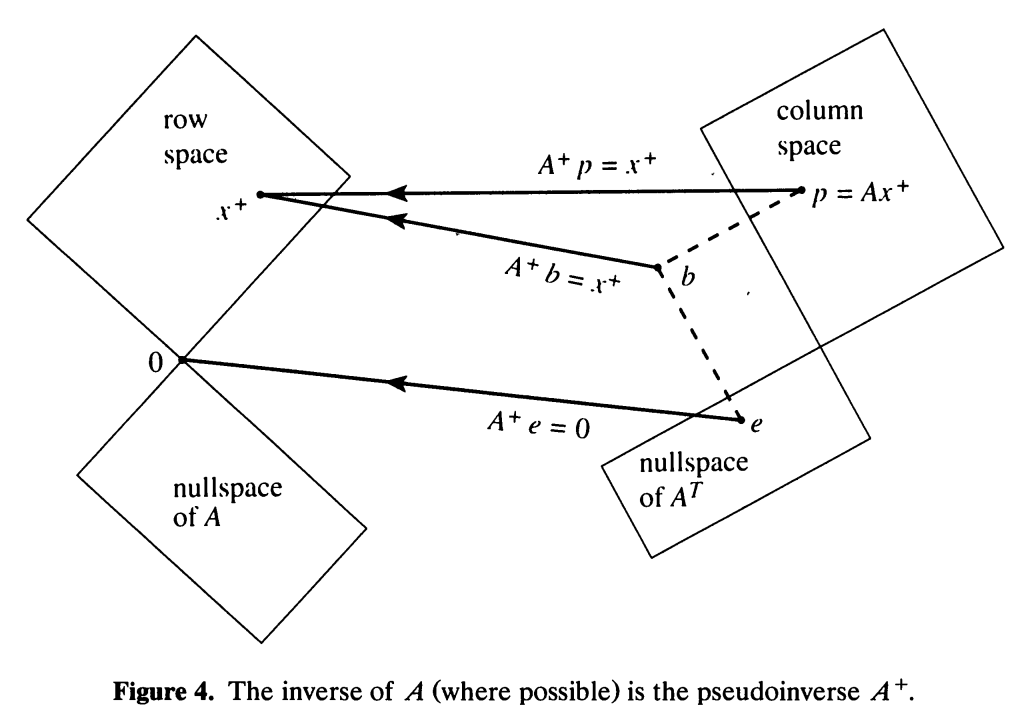
通过SVD由分解得到伪逆;当最小二乘问题存在无穷多个解时(比如矩阵的列线性相关),伪逆给出的解是所有最佳逼近解中长度最短的那个。
MIT18.06数十年前的重点是Jordan标准型,但现在已然是奇异值分解。SVD成为现代科学计算中最浓墨重彩的一笔,它将线性代数深邃的理论美感与广泛的工程实用性无缝地融为了一体。
是以为记,以飨读者。